关键词与条目——每个 Lorebook Entry 字段逐个拆解
Entry 字段一览
每个 Lorebook Entry 包含以下字段:
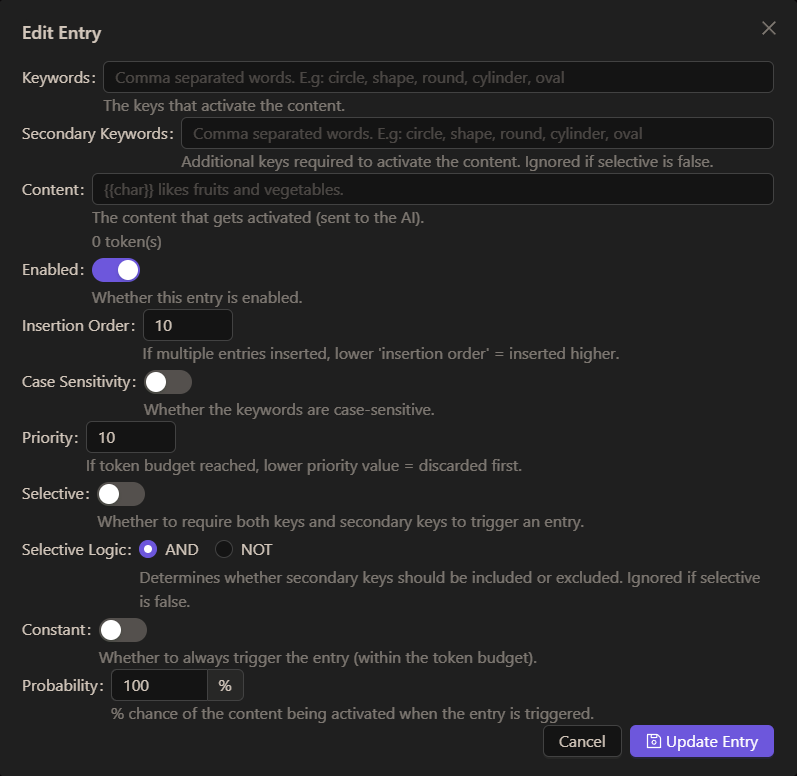
| 字段 | 作用 | 推荐值 |
|---|---|---|
| Keywords | 主关键词列表,聊天历史中出现任意一个即触发 | 用逗号分隔,避免过长的短语 |
| Secondary Keywords | 次级关键词,用于与主关键词组合 | 配合 Selective 使用 |
| Content | 触发后注入到 Prompt 的实际内容 | 写清楚让 AI 知道的世界观信息 |
| Insertion Order | 多个条目同时激活时的排序,数字越小越靠前 | 0 ~ 100,越核心的条目越小 |
| Priority | Token Budget 超限时优先挤掉哪个条目,数字越大越先被挤 | 0 ~ 100,不重要的条目给高值 |
| Case Sensitivity | 是否区分大小写匹配关键词 | 默认否,大多数场景不区分 |
| Selective + Selective Logic | 次级关键词的触发逻辑(AND / OR / NOT) | NOT 最常用:主关键词存在但次级不存在时触发 |
| Constant | 是否无视关键词始终注入 | 慎用,会一直占用 token |
| Probability | 触发后以多大概率实际注入 | 100 = 总是注入 |
匹配规则
- 默认:关键词在扫描深度内出现任意一次 → 匹配成功(大小写不敏感、整词匹配)
- "apple" 会匹配 "apple" 和 "aPPle",但不会匹配 "Applebottom"
Selective Logic 示例
主关键词 = "Apple",次级关键词 = "Banana",Selective Logic = NOT:
- 聊天里只有 "Apple" → 触发(Apple 存在,Banana 不存在)
- 聊天里同时有 "Apple" 和 "Banana" → 不触发(因为 Banana 也存在)
- 聊天里只有 "Banana" → 不触发(Apple 不存在)
最佳实践
- 每个 Entry 的 Content 控制在 50 ~ 200 token,太长会消耗模型上下文
- Keywords 尽量选玩家可能主动说出来的词,不要选 AI 自己很少会提到的内部术语
- 同一主题拆成多个短 Entry,比一个大 Entry 效果更好